


3 Cara Membuat Catatan AI untuk Rapat Rahasia
Rekaman rapat tentang pelanggan atau strategi internal tidak selalu bisa diunggah ke layanan AI eksternal. Namun, bukan berarti Anda harus mengetik setiap kata sendiri. Ada tiga cara untuk mencatat percakapan.
1. Gunakan fitur dikte bawaan
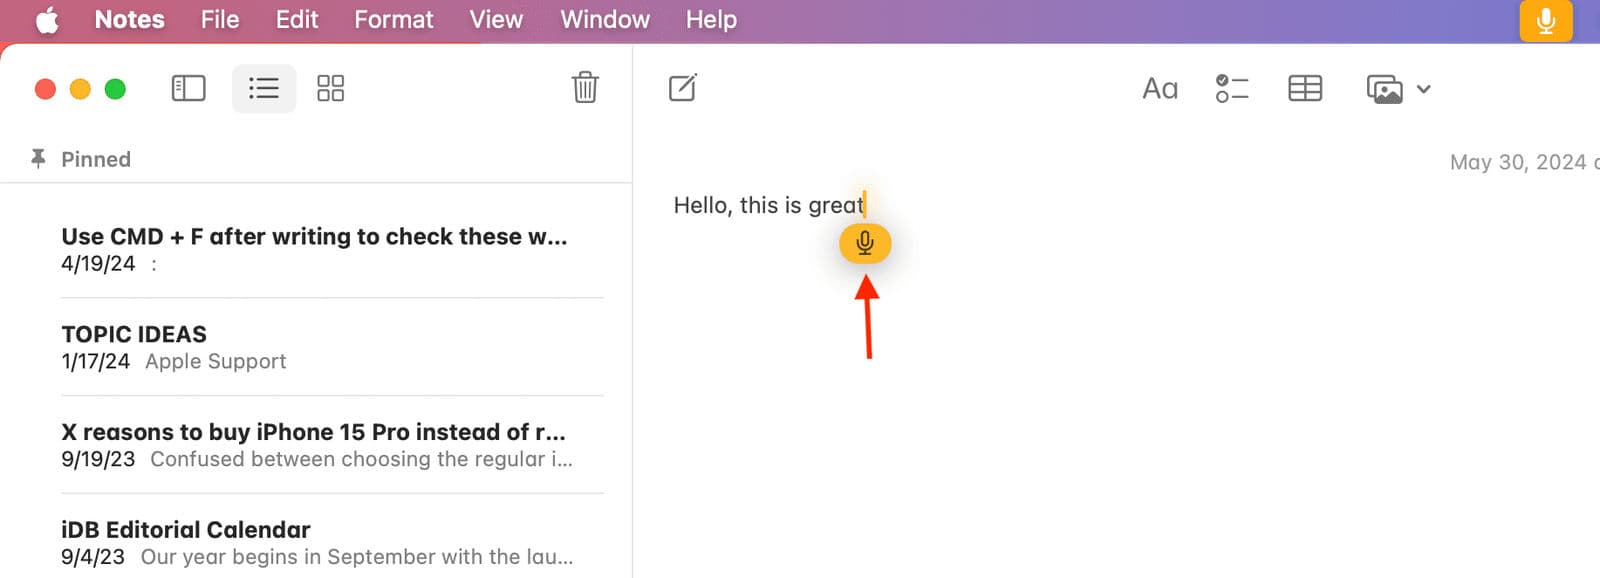
Dikte bawaan komputer atau ponsel dapat mengubah suara menjadi teks tanpa aplikasi khusus. Jika pemrosesan lokal didukung, audio tidak perlu dikirim ke server transkripsi eksternal. Periksa dulu cara pemrosesan untuk perangkat dan bahasa Anda.
Keterbatasannya adalah akurasi di ruang rapat nyata. Kebisingan, gema, dan suara yang jauh dari mikrofon dapat menurunkan kualitas pengenalan. Praktis untuk catatan pribadi singkat, tetapi rapat penuh bisa menyisakan banyak koreksi dan pekerjaan memisahkan ucapan tiap peserta.
2. Bangun sistem di server perusahaan
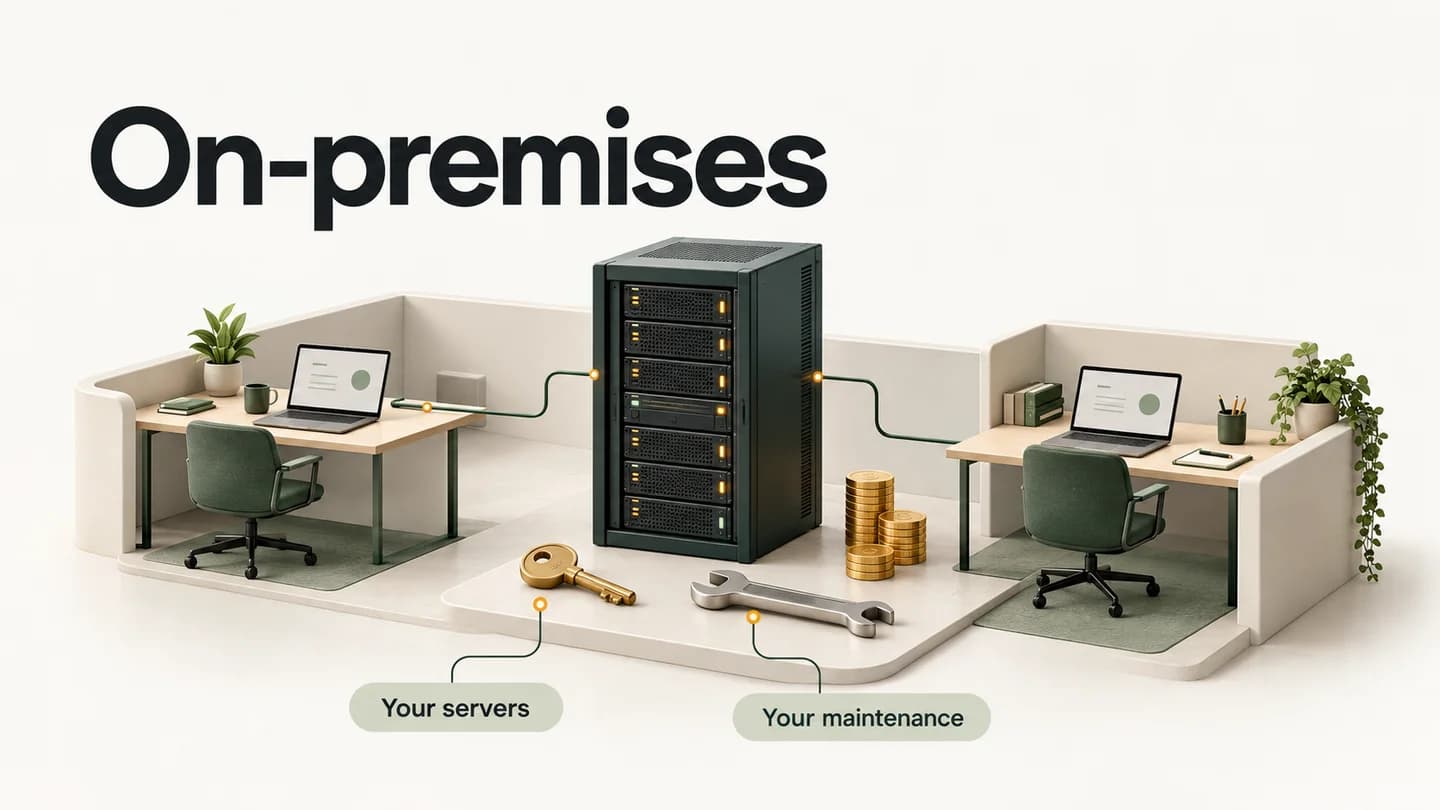
Server pengenalan suara internal memungkinkan perusahaan mengendalikan lokasi pemrosesan, hak akses, dan masa penyimpanan data rapat.
Kendalanya adalah kerumitan dan biaya. Unggahan audio, pemisahan suara, penyuntingan teks, serta pengelolaan pengguna harus terhubung. Setelah itu, server tetap membutuhkan perawatan, pembaruan, dan penanganan gangguan.
Memasang aplikasi notulen AI yang sudah ada sebagai solusi enterprise on-premises juga bisa sangat mahal setelah biaya implementasi, lisensi, infrastruktur, dan dukungan dijumlahkan. Ini komitmen besar bagi tim yang hanya ingin mencatat rapat.
3. Jalankan model AI di komputer sendiri
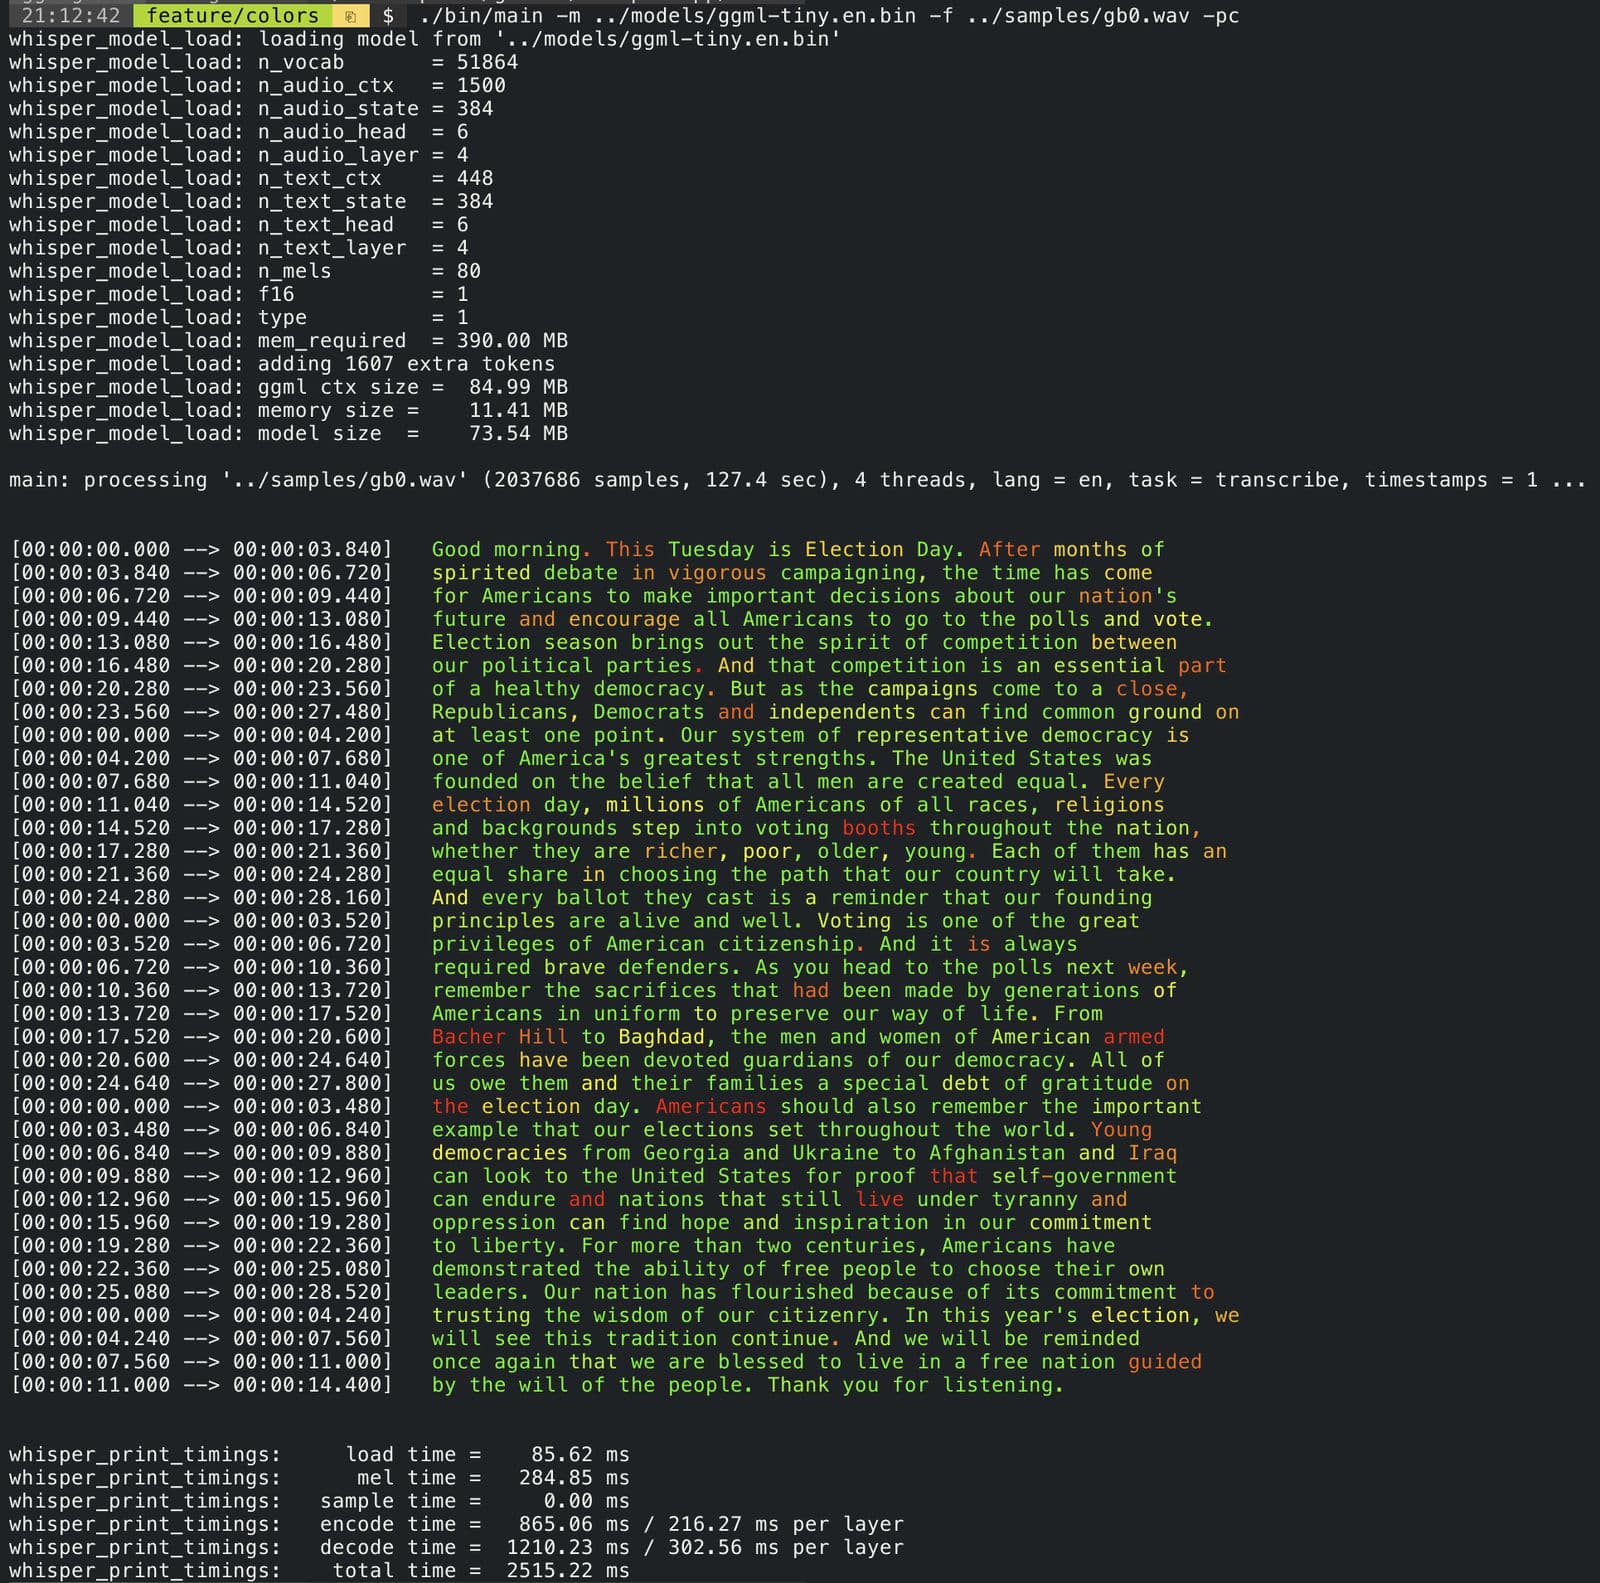
AI di perangkat mengubah audio menjadi teks langsung di komputer Anda, tanpa server tambahan atau unggahan ke layanan transkripsi eksternal.
Salah satu pilihannya adalah Whisper large-v3-turbo dari OpenAI. Model ini mendukung 99 bahasa dan mempercepat transkripsi secara signifikan dengan meminimalkan penurunan akurasi dibanding model besar. OpenAI mencantumkan kecepatan relatif sekitar 8 kali model besar, berdasarkan audio bahasa Inggris pada GPU A100. Kecepatan dan akurasi sebenarnya bergantung pada perangkat dan bahasa.
Mengunduh model baru langkah pertama. Anda perlu memasang lingkungan eksekusi, mengatur akselerasi CPU atau GPU, dan menyesuaikan memori. Untuk membedakan suara peserta, Anda juga memerlukan model lain dan menyelaraskan hasilnya dengan transkrip.
Tidak ingin repot menyiapkan? Coba Alt
Jika tidak ingin mengurus semua pengaturan itu, saya menyarankan Anda mencoba Alt. Aplikasi ini memakai model tersebut dan menyatukan perekaman dengan transkripsi dalam satu alur.
Sesuai perangkat, Alt memanfaatkan CPU, GPU, dan akselerator AI seperti Apple Neural Engine. Pemampatan model melengkapi optimasi tersebut agar pengenalan suara berjalan efisien secara lokal.
Alt Pro mengintegrasikan pengenalan suara sekaligus model pemisahan pembicara ke dalam alur di perangkat. Jadi, aplikasi dapat membedakan siapa mengatakan apa tanpa mengirim audio ke server eksternal.
Ini berlaku untuk mode lokal di perangkat yang didukung. Atur AI cloud, berbagi, dan sinkronisasi sesuai kebijakan keamanan perusahaan.